Příspěvky

Zobrazují se příspěvky se štítkem tech

Creating my own Point of Sale system, Part 1: Design

This took some time, I'm (mostly) back on track. When I chatted with my SI friends, the first thing I noticed was they asked a fuckton of questions. They grilled me about specifications, use cases, reliability or scalability. They also gave insane price quotes but I'll skip over that. The reason is simple: Specifications save time. I am definitely not used to that. I'm used to quickly hacking together a sqlite database for a chatbot in python and iterating bugfixes/feature additions as I go. So I thought, "Why not do it properly for once?" Well, that was also a mistake. The first thing one notices when starting a programming project is the sheer number of decisions. From the programming language to data types, databases and used design patterns, each choice has several impacts and you don't even know the right use case if you don't work with them for some time. So let's start with the language. I am quite fluent with Python (as in, I can solve mo...
Creating my own Point of Sale system, Part 0: Start

Obrázek
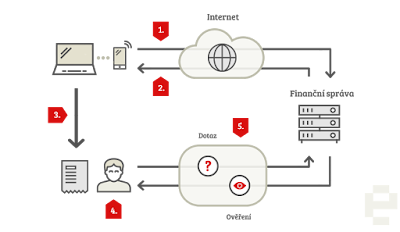
I had several topics I wanted to write about (both from my dabblings in machine learning and travel stories), but a more urgent thing came up. With a change in Czech legislature, all shopkeepers are now required to authorize all transactions at the Ministry of Finances' servers. They call it EET - Elektronicka Evidence Trzeb. (electronic records of sales) Sadly, POS  just reminds me of part-of-speech tags. To deal with the ambiguity, I'll just refer to it as EET system, even though it contains more. So what exactly is EET? From march on, every time we make a sale, we have to contact their servers and send them the amount with our hashed ID we got from them by registering. Afterwards, they send an unique receipt ID back, which we have to print and give to the customer. The customer can then at any point check the receipt on their website. The specifications are all published and the state doesn't require any license to use it. It's rather annoying and requires c...

Co všechno jsem se naučil v Summer Campu

Už je půlka září a příští týden máme poslední meeting. Byla to fantastická příležitost, za kterou jsem eClubu nesmírně vděčný. Naučil jsem se toho spoustu, zvlášť v programování. Používal jsem střídavě Javu, Bash a Python. Python jsem asi procvičil nejvíc, tam jsem dělal všechno možné, včetně webového serveru. Dále jsem měl to potěšení být trestán za věci, co si na univerzitě tolik neosaháte, jako je korektní dokumentace, formátování kódu nebo smysluplné názvy proměnných. Kurz Programování 2 je oproti skutečnému pracovnímu prostředí docela hovno. Mám nově PTSD z kódu, kde chybí mezery mezi operandy (i.e. i+=1 místo i += 1), protože jsem jednou dostal přes 60 připomínek na opravu formátování. Dozvěděl jsem se ale také mnohé lidské poznatky z mého pobytu mezi autisty . programátory. Například: Pozdní příchod na meetingy lze snadno kompenzovat tím, že něco upečete. Je vhodné si pamatovat jména lidí, co sedí u pití. Z veřejné kofoly se velmi snadno stane kofola týmová Nad...

In Soviet Russia, QA systems ask YOU

Poslední dobou dělám samé meniální práce. V jistém smyslu mi to i vyhovuje, ale blbě se tím vytahuje. Teď jsem musel ručně zpracovat 542 otázek . Přišlo mi vtipné, že se tentokrát ptal systém mě. YodaQA ke každé otázce vygeneruje několik clues (předmět otázky, sousloví) a pokusí se v databázi najít k nim náležící koncepty. Například když se ptáte na "Who directed X-Men: Days of Future Past", tak mimo jiné najde koncept "X-Men: Days of Future Past". Nebo nenajde. A pak to je průser. Mým nejnovějším úkolem (zahrnutým v pojmu entity linking) bylo projít nějaký dataset (který jsem předtím vytvořil..) a tam ručně přiřadit koncepty. Občas to bylo lehký, protože ty koncepty vybral správně. Jindy jich namatchoval tucet, protože na jména bez příjmení to najde spoustu mrdek. Nejhorší bylo, když to nenašlo nic, protože ručně hledat koncepty je docela peklo. Musel jsem kvůli tomu pracovat s jazykem SPARQL, který slušně řečeno nedává smysl. Zpočátku jsem to dělal v textovém ...

why don't you just Google it?

Obrázek
Předminulý týden jsem od samotného šéfa dostal za úkol porovnat naší performance s Googlem. Vlastně to probíhalo tak, že se o tom spolu bavili s mým mentorem, který mu na to řekl "Určitě, Roman to zařídí." A tak jsem to zařídil. Nejprve jsem teda netušil, že google nějaký question answering performance vůbec má. Musel jsem kvůli tomu tomu nastavit jazyk v opeře na angličtinu s pomocí přepínače &hl=en. Teď jsme schopni si to nechat zobrazit, ale nejraději bychom to chtěli jako čistý text. Er. Na to se používá nástroj curl, který stáhne celou stránku tak, jak jí dostane prohlížeč. Musel jsem pak řešit fakt, že Google dává pro různé prohlížeče různé výsledky, takže jsem musel zfalšovat můj tkz. user agent. Prostě musel curl při dotazu předstírat, že je firefox. Vpravo je v rámečku přímo odpověď od Googlu Ok, tak jsme schopni stáhnout stránku jako prohlížeč. Koukali jste se někdy na zdrojový kód stránky? Já se maximálně díval na nějaký element, nebo fotku ve facebook...

(Computer) science, bitch

Poslední dobou neřeším přímočaré úkoly, ale naopak věci, které jsou progresivně horší a horší. Začalo to tak, že jsem měl implementovat tkz. fuzzy search v seznamu názvů. To je vyhledávání, které vám vrátí výsledek, i když napíšete otázku s nějakou chybou. Dělá se to tak, že spočítáte editační vzdálenost pro všechna slova a vyberete ta s nejmenší. Editační vzdálenost jenom znamená, kolik změn musíte udělat, abyste přeměnili řetězec A na řetězec B. Například X-Men a X-men má editační vzdálenost 1, protože musíte změnit velké M na malé m. Samozřejmě, ten algoritmus na počítání editační vzdálenosti je přímo úměrný délce slov a těch slov máte řadově 10 na sedmou (10 000 000), takže pro každý dotaz počítat 10^7 editačních vzdálenosti je dosti nemocné. A co teď. Vědecký článek, podle kterého jsem to implementoval, uváděl dvě možnosti. Jedna byla aproximační (tj. nemá zaručeno, že slovo najde, přestože existuje) a rychlá, druhá kompletní ale 100 krát pomalejší. První fungovala na bázi b...

Nekonečná nenávist

Obrázek
Nějaký čas jsem si myslel, že to s mojí preferencí Thinkpadů a jiných "průmyslových" notebooků trochu přeháním. Jako dobře, má to pevnou konstrukci a ta klávesnice mi docela vyhovovala (nemluvě o tom, že se mi ten design subjektivně velmi líbil), ale ostatní notebooky na tom přece nebudou o tolik hůř. Modularitu stejně tolik nevyužívám (maximálně jsem vyměnil HDD) a dokud ten stroj bude mít alespoň sandy bridge procesor od intelu, tak to přece bude normálně použitelný. Přišlo mi to mírně (dobře, dost) elitistické. Byl jsem včera přesvědčen, že bych u thinkpadů měl rozhodně zůstat. Dostal jsem totiž nějaký příšerný MSI (nemám sílu hledat model a ono to je stejně všechno konzumní odpad), na který jsem chtěl nainstalovat Windows 10. Když započítám (dvakrát) dobu stažení a dva nevysvětlitelné errory, kvůli kterým jsem to musel restartovat, tak to trvalo kolem 12 hodin čistého času. Bylo to směšně pomalé. Předpokládám, že to je dáno 4 nebo 5 let starým pevným diskem, ale jaké...

YodaQA, týden třetí

Včera jsem si odchodil dalších 24 hodin, co mám týdně. (3 krát 8 hodin)  Dvakrát se něco rozbilo a já to musel trochu v panice opravovat, protože už jsem to odeslal do hlavní větve. Nakonec jsem ale to webové rozhraní vylepšil, teď se u jednotlivých odpovědí zobrazují odkaz strategie, jak k nim YodaQA dospěl, což v praxi znamená jenom "hledal jsem v celém dokumentu, hledal jsem v názvu, hledal jsem v strukturované databázi. Přímo důvody mě ještě čekají, to bude trvat déle.  Vtipné bylo, že v úterý jsem musel místo programování testovat naší filmovou odnož a to spočívalo v tom, že jsem měl otevřený spreadsheet a do toho si zaznamenával otázky a odpovědi. Vtipné to vlastně není. Je to příšerný vopruz. U generických otázek to alespoň občas dá nějakou překvapivou otázku, ale tady strojově (chápete? strojově, hahahaha) hledáte mezi 25 nabízenými větami správnou odpověď. Zatím náš systém docela selhává, i otázky typu "kdo režíroval X" občas posere. Problém je trochu v...

Zajatcem svobody

Obrázek
Mám poměrně dost elektroniky a jelikož jsem další znuděný student, co nemá nic lepšího na dělání, tak řeším nesmysly jako distribuce linuxu . Je to vtipné, protože 4 z 5 strojů používají nějakou variantu Windows . Tam jsem se s vzhledem nijak neobtěžoval, je tam hrozný bordel a prostě to nějak funguje. V rámci předmětu operační systémy a sítě jsme si hráli s linuxem. Instalovat jsme ho nemuseli, ale bylo nám to silně doporučováno. Začal jsem s Linux Mint, překrásný derivát Ubuntu s desktopovým prostředím Cinnamon. Tady začíná první problém, protože těch desktopových prostředí je víc než 1! Cinnamon (a tedy celý Mint) fungoval překrásně hned po instalaci na Thinkpad x61s. Bylo to pěkný, svižný, pohodlný a prostě to fungovalo. Zároveň to však bylo moc.. defaultní? Out of the box? Nijak extra jsem to neupravoval, protože nebylo moc co, ačkoliv linux samotný to umožňuje. Chtěl jsem tedy něco víc osobního, i kdybych musel 4 víkendy všechno konfigurovat, aby se to chovalo stejně jak...

YodaQA

Obrázek
Tohle bude takové menší neoficiální povídání o mém působení v summer campu eClubu, kam jsem se letos přihlásil. To je taková brigáda, kdy vám dají 8000,- měsíčně za to, že spolupracujete na všemožných projektech souvisejících s big data, machine learningem, domácí automatizací, cloudem či mobilních aplikací. Přiznám se, že můj vstupní pohovor dopadl příšerně. Přišel jsem fakt nepřipravený a asociální a hned při první otázce jsem zamrzl. Bylo to "Co vás baví?" Ach jo. Tohle musím natrénovat. Každopádně ze mě vypáčil, že vím, co je to quicksort a linked list a rovnou mě přiřadil. Nevím, jestli mě tím odbyl, ale tvářil se, že to je dobrá nabídka. Doteď nevím, jestli se ke mně Big Boss chová ironický, nebo ne. Každopádně můj projekt je (zatím..) YodaQA, neboli "Yet anOther Deep Answering pipeline", což je ve zkratce (open source!) systém, kterému dáte nějakou konkrétní otázku, jako například "Who wrote Neuromancer" a ono to tu otázku analyzuje a dá vám kon...